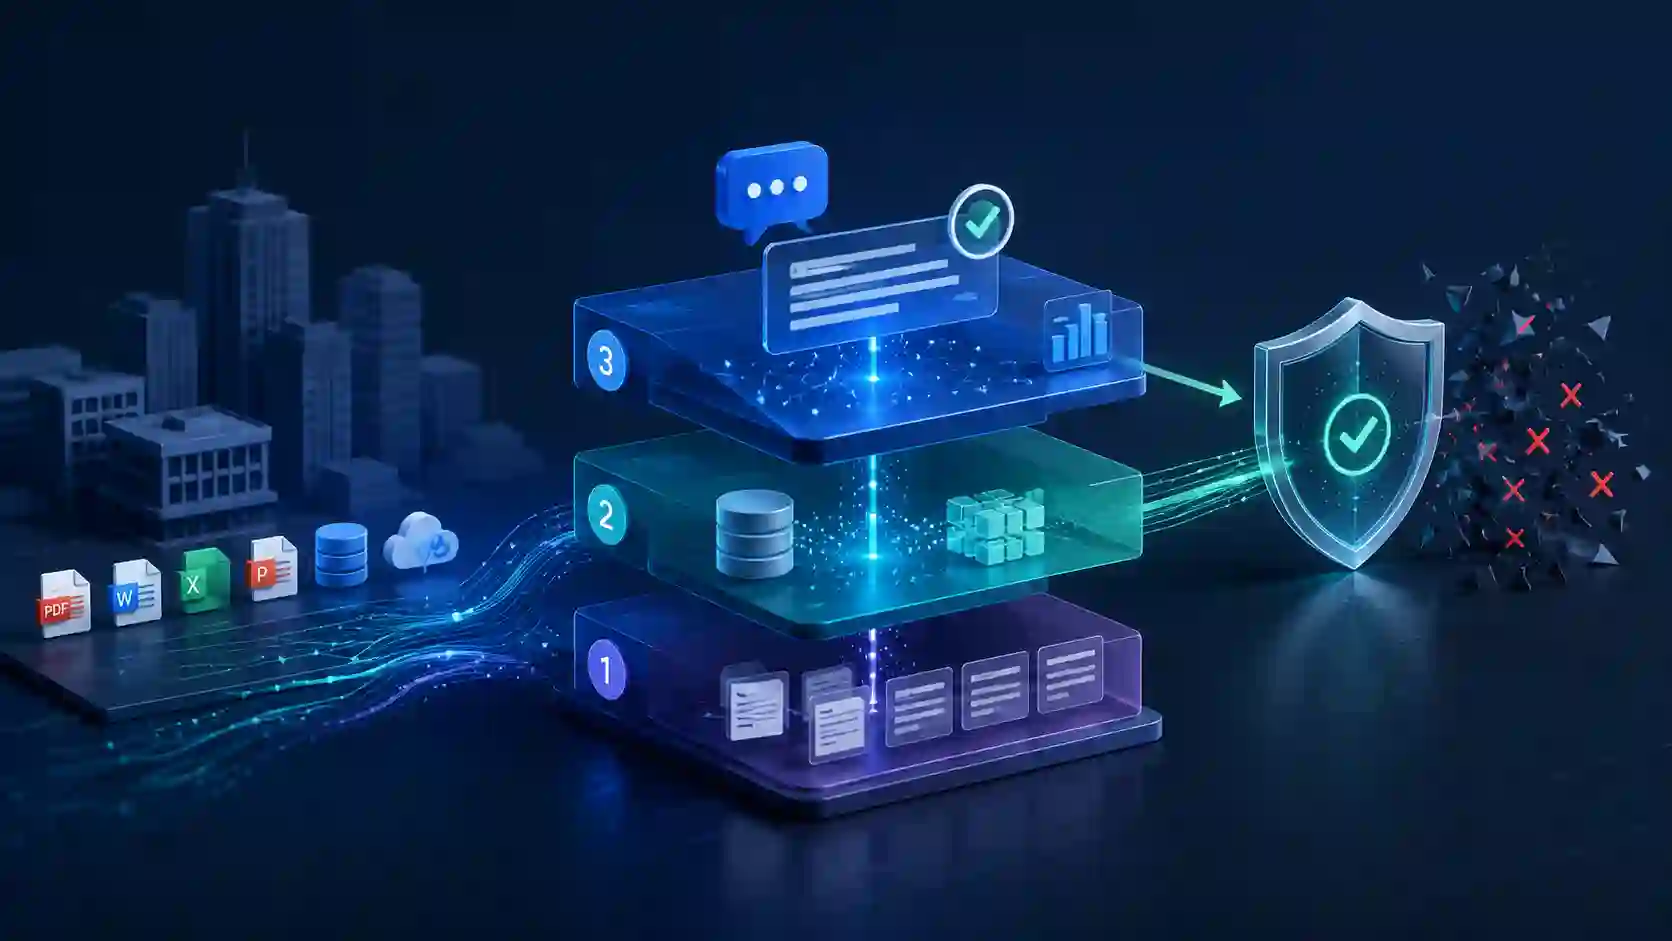
結論から言います。 RAGのハルシネーション(hallucination)は、より「賢い」モデルに乗り換えるだけでは制御できず、運用アーキテクチャで抑えるものです。日本のエンタープライズ案件(保険、公共分野)で私が用いるのは、入力を制御し、検索(リトリーバル)を制約し、出力をレビューする、3層の制御フレームワークです。これにより、誤答リスクを下げ、問題が起きた際に追跡できるようにします。
TL;DR(エグゼクティブサマリー)
- 課題: 日本の大手保険5グループおよび公共分野のAIプロジェクトでCustom RAG/AIチャットボットを導入。ここでは一つの誤答(ハルシネーション)が「小さなバグ」ではなく、法的・信用上のリスク(金融庁=FSAコンプライアンス)に直結します。
- 解決策: LLMの「賢さ」に頼るのではなく、3層レビュー(3-Tier Review) フレームワーク ―― 入力ゲーティング、検索グラウンディング、ヒューマン・イン・ザ・ループによる出力レビュー。
- 結果: カスタマーサポートの運用コストを大幅に削減しつつ、精度とコンプライアンスを管理する仕組みを運用全体で維持しました。
ハルシネーションとは、運用の観点から見ると何か?
多くの記事は、ハルシネーションを学術的に「モデルが事実でない情報を生成すること」と定義します。正確ですが、運用に責任を負う立場ではほとんど役に立ちません。
デリバリーマネージャー/システムアーキテクトの視点から、私はこう定義し直します。ハルシネーションとは、システムが「根拠となるデータを持たないこと」について自信満々に答えてしまう状態です。 核心的な問題は「モデルがでっち上げる」ことではなく、システムに「分かりません」と認める仕組みがないことにあります。
SMEの現場であれば、誤答は単に相手を苛立たせる程度かもしれません。しかし日本の保険分野では、約款の条項を誤って説明するチャットボットは法的責任を招きかねません。この二つは同じリスク階級ではないため、同じアーキテクチャを使うことはできないのです。
なぜ「より良いモデルを使う」では解決しないのか?
これは最もよくある落とし穴です。チャットボットがでっち上げをすると、まず「より強力なモデルに替えよう」と考えがちです。しかし強力なモデルは、より説得力をもってハルシネーションを起こすだけで、いつ沈黙すべきかは依然として分かりません。
本当の理由はこうです。ハルシネーションの多くは生成(generate)の段階ではなく、検索(retrieval)の段階で発生します。システムが誤った文書を検索したり、何も取得できないのにモデルに無理やり答えさせたりすれば、どれほど「素直な」モデルでも、その空白を推測で埋めてしまいます。だからこそ私はいつもこう言います。RAGはモデル選定の問題ではなく、データアーキテクチャの問題であると。
ハルシネーションを防ぐ3層レビュー・フレームワーク
これは、私がエンタープライズのCustom RAGシステムに適用しているフレームワークです。各層は異なる種類の誤りを防ぎます。そして重要なのは、それぞれが独立していること ―― どの層も単独で全責任を負うことはありません。
第1層 ―― 入力ゲーティング(Input Gating)
質問がLLMに到達する前に、システムはそれを分類します。この質問は、システムが答えてよい対応範囲内か? 対応範囲外(out-of-scope)の質問は即座にブロックし、別ルートへ誘導します ―― モデルに無理に答えさせて、でっち上げを生ませるのではなく。
非構造化データ(契約書のPDF、スキャン文書)の場合、この層にはOCR+自動スクリーニングも含まれます。インデックス化する前に、原資料を正規化しノイズを除去するのです。ゴミを入れればゴミが出る ―― これはどのモデルにも救えません。
第2層 ―― 検索グラウンディング(Retrieval Grounding)
これは最も重要でありながら、最も見落とされがちな層です。原則はこうです。モデルは検索された文書のみに基づいて答えてよく、その出典を提示できなければならない。 検索結果の類似度が閾値を下回った(十分に関連する文書が見つからない)場合、システムは推測モードに移行するのではなく、強制的に「情報がありません」と答えます。
言い換えれば、私はシステムが「分かりません」と言えるように設計します。それは欠陥ではなく、機能なのです。
第3層 ―― ヒューマン・イン・ザ・ループによる出力レビュー
リスクの高い領域では、すべての回答が顧客へ直接送られるわけではありません。機微な領域(条項、金額、法的なコミットメント)に触れる回答は、送信前に人によるレビューを経由させます。よくある質問の大部分は負荷軽減のため完全に自動化し、「コストの高い」回答にだけ人を関与させます。
この設計 ―― 安価な部分は自動化し、高価な部分には人を残す ―― こそが、コンプライアンス管理を犠牲にすることなく運用コストを大幅に削減できた要因です。
第2層の内側:チャンキングから評価までの5段階パイプライン
上の3層フレームワークは「どこで制御するか」に答えるものです。ここではもう一層下、第2層の下で動く検索エンジンそのものに踏み込みます。本当に「動く」Custom RAG は、モデル選定の段階で決まるのではなく、検索(retrieval)パイプラインで決まります。文書をどうチャンキングするか、どのモデルで埋め込むか、ハイブリッド検索(ベクトル+BM25)を行うか、リランクするか、そして最も重要なのは——何で測定するか。市場に出回る「RAG」の多くは、これらの層を一切持たないLangChainデモ止まりです。きれいな5つの質問、整ったドキュメント、単一言語なら動きますが、スキャンPDF、条項の表、ベトナム語と日本語が混在するクエリ、正解が「該当する情報はありません」である質問では捏造します。以下は、私が日越多言語RAGで実際に使っているパイプラインと、数値の入ったeval表です。
5段階パイプライン——各段階が塞ぐ失敗
第1段階 — チャンキング:多くのシステムが静かに死ぬ場所
既定のやり方——512トークン固定+オーバーラップ——は、最も精度を要する文書をまさに破壊します。条項の表が行の途中で切られれば文脈を失い、800トークンの条項が二つに裂かれれば、どのチャンクにも完全な意味が残りません。
私が使うのはstructure-awareチャンキングです。固定トークン数ではなく、文書の意味的境界——見出し、条・項、表のセル境界——に沿って切ります。狙いは、各チャンクがそれ自体で完結する意味単位であること。通常300〜500トークン、境界の文脈を保つためオーバーラップを約15%。表については行構造を保持(row-aware)し、各行に列見出しを付与します。ユーザーは孤立したセルではなく、行で質問するからです。
チームに必ず言う原則:インデックスに入ったゴミは、どんなリランカーでも救えません。チャンキングは最も安価な層でありながら、システム全体の品質の上限を決めます。
第2段階 — 埋め込み:単一言語モデルは日越市場における罠
ベトナム語の質問が、日本語で書かれた条項を検索する必要がある——これは仮定ではなく実際の状況です。単一言語の埋め込みモデル(あるいは英語に最適化されたモデル)はここで脱落します。私はviとjaを一つの共有ベクトル空間に置く多言語埋め込みモデルを選び、言語横断検索(cross-lingual retrieval)が機能するようにします。
見落とされがちな点:専門用語です。保険商品名、業務コード、社内略語——汎用埋め込みはこれらを誤って解釈します。私はグロッサリーを保持し、これらの実体をインデックス側とクエリ側の両方で処理して、意味的に「誤訳」されないようにします。
第3段階 — ハイブリッド検索:ベクトルは意味に強く、完全一致に弱い
これがデモRAGと本番RAGを分ける段階です。ベクトル検索は意味で探します——言い換えられた質問には抜群です。しかしユーザーが契約番号 HD-2024-887 や条項コード 第12条を打つとき、意味はほぼ無力です。必要なのは完全なキーワード一致です。
解決策は、二つのリトリーバーを並列に走らせること——dense(ベクトル)+ sparse(BM25)——そしてReciprocal Rank Fusionで統合します。ベクトルが言い換えの質問を、BM25が識別子と希少語を捕捉します。この段階だけで、パイプライン全体で最大のリコール上昇になることが多いです。
第4段階 — リランキング:「十分に関連」と「まさに正しい」を分ける
リトリーバーはtop-kを高速に返しますが粗い。クロスエンコーダのリランカーが(質問, チャンク)の各ペアを読み直して真の関連度を採点し、粗いtop-50を精密なtop-5へ絞ります。違いはこうです。リトリーバーは質問とチャンクを独立に埋め込みますが、リランカーは両者を一緒に見るため、コサイン類似度が見落とすニュアンスを捉えます。
代償はレイテンシです——リランクは時間を要します。だから私は粗いtop-k(50)だけをリランクし、コーパス全体はリランクしません。他のあらゆるアーキテクチャ判断と同じく、案件ごとに調整するトレードオフです。
第5段階 — eval:測定できないなら、それを所有していない
これは、RAGを運用する人とRAGをデモする人を分ける段階です。evalがなければ、あらゆる「改善」は感覚にすぎず、ある変更がシステムを良くしたのか悪くしたのか決して分かりません。
私はゴールデンセットを構築します。数百組の(質問 → 正しい出典文書 → 期待される回答)で、正解が*「該当する情報はありません」*である質問も含めます。そして責任を分離する指標で測定します。
- Recall@k — 正しい文書はtop-kに含まれているか?(検索段階のみを測る)
- Faithfulness/Groundedness — 回答は検索結果に根拠づけられ、何も捏造していないか?(生成段階のみを測る)
- 正しい「分かりません」率 — 出典がないとき、システムは推測せず「該当情報なし」と言えるか?
eval表:各技術を積み上げる
同一のゴールデンセットに対して各段階を有効化したときに、私がよく見る結果の形です。数値は載せません。文書セットごとに水準が違い、特定の案件に紐づかない割合の表は実測値として読まれやすいためです。
| 構成 | 最も動きやすい指標 | 塞がれる失敗の種類 |
|---|---|---|
| Naive(固定チャンク+ベクトルのみ) | —(比較の基準) | — |
| + Structure-awareチャンキング | Recall@5、Faithfulness | 条項や表が途中で切れ、取得した箇所の意味が欠ける |
| + ハイブリッド検索(BM25) | Recall@5 | ベクトル検索が取りこぼす番号・固有名詞・条項番号 |
| + リランカー | Faithfulness | 意味は近いが誤った箇所が上位に来る |
重要なのはその経路です。各段階が固有の失敗を塞ぎ、どの段階が金を払う価値があるかは、この表があって初めて分かります。何で測定するかを言えないままRAG案件を見積もるチームは、たいてい本番での誤答に責任を負ったことのないチームです。
このRAGは何で「ない」のか——誤って買わないために
期待値について率直に言います。このパイプラインは、SMEから中堅企業規模における企業文書セット(ナレッジベース、契約、社内手順)に対する精度に最適化されています。以下ではありません:
- 数十億ベクトルをリアルタイム処理する基盤——それは別のインフラ問題であり、専任のデータエンジニアリングチームを要します。
- 「絶対に誤り0%」の約束——どんなシステムもそれは約束できません。あなたが買うのは、制御可能で測定可能な誤差です。
- 出典データの品質を飛ばす言い訳——出典文書が乱れていれば結果も乱れます。それはモデルを語る前にやるべき仕事です。
誤答に実際のコストが伴うプロセスにRAGを導入することを検討していて、システムをデモするだけでなく測定する人と組みたいなら、AI自動化の対応領域をご覧いただくか、実際のプロジェクトストーリーを読むか、システムの課題を送るからご相談ください。
このアーキテクチャが「不要」なのはどんなときか?
私は、あらゆる課題に重厚なアーキテクチャを押し付けることを良しとしません。この3層フレームワークが不要なのは、次のような場合です。
- 社内の参照ツールで、多少の誤りが無害であり、法的な露出もない場合。
- 質問量が少なく、手動レビューのほうがパイプライン構築より安く済む場合。
- 「おおむね正しい」回答が許容される領域(例:コンテンツの提案、ブレインストーミング)。
そうした場合は、シンプルなRAG ―― あるいはRAGを使わないこと ―― が正しい選択です。「AIに間違った場所で投資して燃やしてしまう」落とし穴については、自動化の失敗から得た教訓で書きました。
3層アーキテクチャは、誤答に本当の代償があるときのためのものです。そしてそのときこそ、それは一円の価値も無駄にしません。
誤りに本当の代償が伴うプロセスへAI/RAGを導入すべきか検討中で、こうしたシステムを設計から運用まで一貫して担ってきた人材をお探しでしたら、AI自動化の対応領域をご覧いただくか、実際のプロジェクト事例をお読みください。あるいはシステム課題のご相談から、直接お話しいただければと思います。
Nguyen Chau
Delivery Manager / System Architect
日越市場におけるシステムの設計・運用で14年の経験
よくある質問
なぜ高性能モデルにしてもハルシネーションは解決しないのですか?
モデルやインフラではなく、原資料の正規化(第1層)と、閾値・レビューフローの設計(第2〜3層)です。ここは「地味」ながら、システムが生きるか死ぬかを決める部分です。モデルの費用しか見積もらないベンダーは、たいてい厳しい環境で本物のRAGを運用した経験がありません。その下で動く検索エンジンそのもの——チャンキング、ハイブリッド検索、リランキング、そして数値の入ったeval表——は、本記事の5段階パイプラインの節で開けてみせます。
3層のハルシネーション対策が不要なのはどんなときですか?
コンテンツ提案や一般情報の照会など、小さな誤りが重大な結果を招かない場合です。3層構成はコストと遅延を増やすため、誤答が法的・金銭的リスクを生む場合にのみ見合います。
RAGシステムを評価する上で最も重要な指標は何か?
モデルでもベクトルDBでもなく、出典データの正規化(第1段階)とevalセットの構築(第5段階)です。これらは「地味」でありながら、システムの生死を決める部分です。モデルAPI呼び出しの費用しか見積もらないチームは、たいてい誤差に実際の代償が伴う環境で本物のRAGを運用したことのないチームです。
純粋なベクトル検索ではなくハイブリッド検索が必要になるのはいつか?
正しい答えは「規模による」であって「いま流行りのもの」ではありません。SME規模なら、pgvectorを備えたPostgresで十分なことが多く、運用も簡単です。ベクトル数とレイテンシ要件が増えて初めて、専用ベクトルDB(Qdrant、Milvusなど)が追加の運用コストに見合います。規模を知る前にベクトルDBを選ぶのは、本末転倒です。