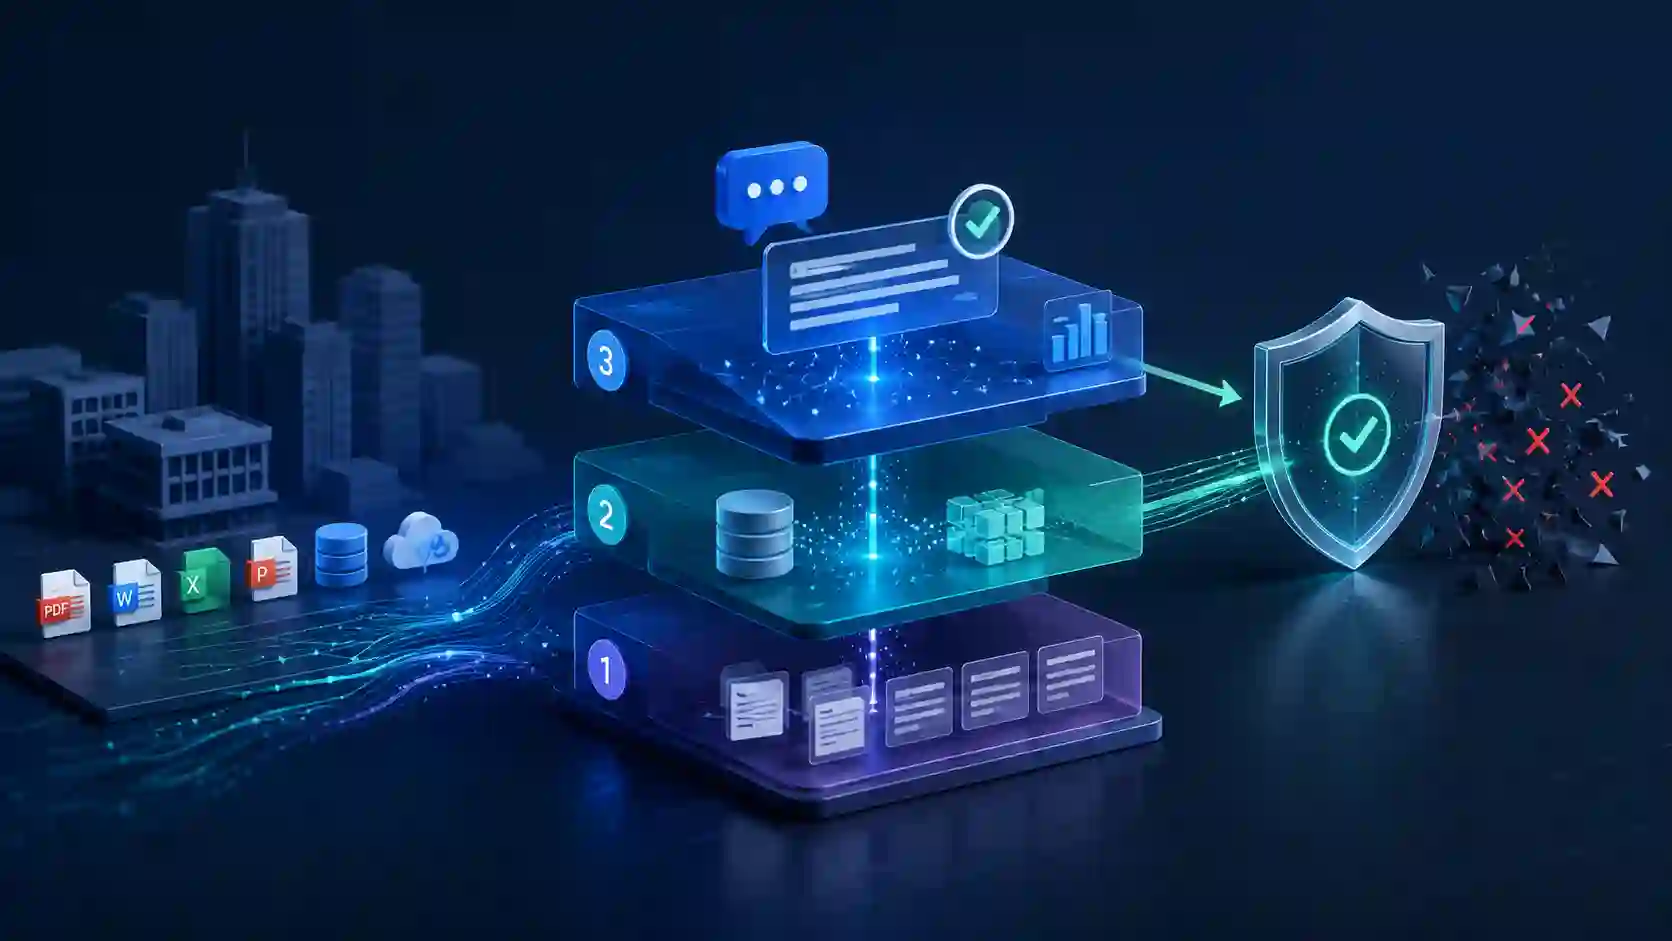
Câu trả lời ngắn: Bạn không kiểm soát ảo giác (hallucination) của RAG bằng cách đổi sang một model "xịn" hơn — bạn kiểm soát bằng kiến trúc vận hành. Trong các dự án enterprise Nhật (bảo hiểm, khu vực công), tôi dùng một khung 3 lớp: chặn ở input, ràng buộc ở retrieval, và review ở output. Cách này làm giảm rủi ro trả lời sai và giúp truy vết khi lỗi xảy ra — thay vì kỳ vọng model "tự nhiên thông minh".
TL;DR (Executive Summary)
- Bài toán: Triển khai Custom RAG / AI Chatbot cho 5 tập đoàn bảo hiểm lớn và một dự án AI khu vực công tại Nhật — nơi một câu trả lời sai (hallucination) không phải "bug nhỏ" mà là rủi ro pháp lý và mất uy tín (FSA compliance).
- Giải pháp: Một khung 3 lớp (3-Tier Review) — kiểm soát đầu vào, ràng buộc truy hồi (retrieval grounding), và human-in-loop ở đầu ra — thay vì phụ thuộc vào "độ thông minh" của LLM.
- Kết quả: Giảm đáng kể chi phí vận hành chăm sóc khách hàng, đồng thời giữ cơ chế kiểm soát độ chính xác và tuân thủ trong suốt vòng đời vận hành.
Hallucination thực ra là gì — dưới góc nhìn vận hành?
Đa số bài viết định nghĩa hallucination theo kiểu học thuật: "mô hình sinh ra thông tin không có thật". Định nghĩa đó đúng nhưng vô dụng khi bạn phải chịu trách nhiệm vận hành.
Dưới góc nhìn một Delivery Manager / System Architect, tôi định nghĩa lại: hallucination là khi hệ thống trả lời một cách tự tin về thứ nó không có cơ sở dữ liệu để khẳng định. Vấn đề cốt lõi không phải "model bịa" — mà là hệ thống không có cơ chế thừa nhận "tôi không biết".
Trong môi trường SME, một câu trả lời sai có thể chỉ gây khó chịu. Trong môi trường bảo hiểm Nhật, một chatbot tư vấn sai điều khoản hợp đồng có thể kéo theo trách nhiệm pháp lý. Hai bài toán này không cùng một class rủi ro, nên không thể dùng chung một kiến trúc.
Vì sao "dùng model xịn hơn" không giải quyết được?
Đây là cái bẫy phổ biến nhất. Khi chatbot bịa, phản xạ đầu tiên là "đổi sang model mạnh hơn". Nhưng model mạnh hơn chỉ bịa thuyết phục hơn — nó không tự biết khi nào nên im lặng.
Lý do thật: hallucination phần lớn không sinh ra ở bước generate, mà ở bước retrieval. Nếu hệ thống truy hồi nhầm tài liệu, hoặc truy hồi được tài liệu rỗng nhưng vẫn ép model trả lời, thì model "ngoan" mấy cũng sẽ lấp khoảng trống bằng phỏng đoán. Đây là lý do tôi luôn nói: RAG là bài toán kiến trúc dữ liệu, không phải bài toán chọn model.
Khung 3 lớp chống ảo giác (3-Tier Review Framework)
Đây là framework tôi áp dụng cho các hệ thống Custom RAG enterprise. Mỗi lớp chặn một loại sai khác nhau — và quan trọng là chúng độc lập, không lớp nào gánh hết trách nhiệm.
Lớp 1 — Kiểm soát đầu vào (Input Gating)
Trước khi câu hỏi chạm tới LLM, hệ thống phân loại: câu này có nằm trong phạm vi hệ thống được phép trả lời không? Câu ngoài phạm vi (out-of-scope) bị chặn ngay và chuyển hướng — thay vì để model cố trả lời rồi bịa.
Với dữ liệu phi cấu trúc (PDF hợp đồng, văn bản scan), lớp này còn bao gồm OCR + auto-screening: chuẩn hoá tài liệu nguồn và loại bỏ phần nhiễu trước khi đưa vào index. Rác đầu vào = rác đầu ra, không model nào cứu được.
Lớp 2 — Ràng buộc truy hồi (Retrieval Grounding)
Đây là lớp quan trọng nhất nhưng hay bị bỏ qua. Nguyên tắc: model chỉ được trả lời dựa trên tài liệu đã truy hồi, và phải trích dẫn được nguồn. Nếu retrieval trả về độ tương đồng dưới ngưỡng (không tìm thấy tài liệu đủ liên quan), hệ thống bắt buộc trả lời "không có thông tin" — chứ không chuyển sang chế độ phỏng đoán.
Nói cách khác: tôi thiết kế để hệ thống được phép nói "tôi không biết". Đó là tính năng, không phải lỗi.
Lớp 3 — Human-in-loop ở đầu ra (Output Review)
Ở domain rủi ro cao, không phải câu trả lời nào cũng bắn thẳng ra khách. Những câu chạm vùng nhạy cảm (điều khoản, số tiền, cam kết pháp lý) được route qua review của con người trước khi gửi. Phần lớn câu hỏi thường gặp vẫn tự động hoá hoàn toàn để giảm tải; chỉ phần "đắt" mới cần người.
Chính thiết kế này — tự động hoá phần rẻ, giữ người ở phần đắt — là cái giúp giảm đáng kể chi phí vận hành mà không đánh đổi bằng rủi ro compliance.
Bên trong Lớp 2: pipeline retrieval 5 tầng từ chunking đến eval
Khung 3 lớp ở trên trả lời câu kiểm soát ở đâu. Phần này đi xuống một tầng sâu hơn: chính cái retrieval engine bên dưới Lớp 2. Một Custom RAG "chạy được" không được quyết định ở bước chọn model, mà ở retrieval pipeline: chunk tài liệu thế nào, embed bằng model nào, có hybrid search (vector + BM25) không, có rerank không, và quan trọng nhất — đo nó bằng gì. Phần lớn "RAG" ngoài thị trường dừng ở demo LangChain không có lớp nào trong số này: thử trên 5 câu hỏi đẹp, tài liệu sạch, một ngôn ngữ thì chạy; gặp PDF scan, bảng điều khoản, truy vấn lẫn tiếng Việt và tiếng Nhật, hay câu hỏi mà đáp án đúng là "không có thông tin" thì bịa. Dưới đây là pipeline thật tôi dùng cho RAG đa ngôn ngữ Việt–Nhật, kèm bảng eval có số.
Pipeline 5 tầng — và lỗi mà mỗi tầng đóng lại
Tầng 1 — Chunking: chỗ hầu hết hệ thống chết âm thầm
Cách mặc định — cắt cố định 512 token với overlap — phá nát đúng những tài liệu cần chính xác nhất. Một bảng điều khoản bị cắt giữa dòng thì câu trả lời mất ngữ cảnh; một điều khoản dài 800 token bị xé làm đôi thì không chunk nào còn đủ nghĩa.
Cái tôi dùng là structure-aware chunking: cắt theo ranh giới ngữ nghĩa của tài liệu — heading, điều/khoản, ranh giới ô bảng — chứ không theo số token cứng. Mục tiêu: mỗi chunk là một đơn vị ngữ nghĩa tự đứng được, thường 300–500 token, overlap ~15% để giữ ngữ cảnh giáp ranh. Với bảng, tôi giữ nguyên cấu trúc hàng (row-aware) và đính kèm tiêu đề cột vào mỗi hàng, vì người dùng hỏi theo hàng chứ không theo ô rời.
Quy tắc tôi luôn nhắc đội: rác đi vào index thì không reranker nào cứu nổi. Chunking là tầng rẻ nhất nhưng quyết định trần chất lượng của cả hệ thống.
Tầng 2 — Embedding: model đơn ngữ là cái bẫy ở thị trường Việt–Nhật
Một câu hỏi tiếng Việt cần truy ra một điều khoản viết bằng tiếng Nhật — đây là tình huống thật, không phải giả định. Embedding model đơn ngữ (hoặc tối ưu cho tiếng Anh) sẽ rớt thẳng ở đây. Tôi chọn embedding model đa ngôn ngữ đặt vi và ja chung một không gian vector, để truy hồi xuyên ngôn ngữ (cross-lingual retrieval) hoạt động.
Một chi tiết hay bị bỏ: thuật ngữ chuyên ngành. Tên sản phẩm bảo hiểm, mã nghiệp vụ, từ viết tắt nội bộ — embedding generic hiểu sai chúng. Tôi giữ một glossary và xử lý các thực thể này ở cả index lẫn query để chúng không bị "dịch nghĩa" sai.
Tầng 3 — Hybrid search: vector giỏi ngữ nghĩa, dở khớp chính xác
Đây là tầng phân biệt RAG demo với RAG production. Vector search tìm theo ý nghĩa — rất mạnh cho câu hỏi diễn giải. Nhưng khi người dùng gõ số hợp đồng HD-2024-887 hay mã điều khoản 第12条, ngữ nghĩa gần như vô dụng; bạn cần khớp từ khóa chính xác.
Giải pháp là chạy song song hai retriever — dense (vector) + sparse (BM25) — rồi hợp nhất bằng Reciprocal Rank Fusion. Vector bắt câu hỏi diễn giải, BM25 bắt mã định danh và thuật ngữ hiếm. Riêng tầng này thường là cú nhảy recall lớn nhất trong cả pipeline.
Tầng 4 — Reranking: tách "đủ liên quan" khỏi "đúng cái cần"
Retriever trả về top-k nhanh nhưng thô. Một cross-encoder reranker đọc lại từng cặp (câu hỏi, chunk) và chấm điểm liên quan thật sự, kéo top-50 thô xuống còn top-5 tinh. Khác biệt: retriever embed câu hỏi và chunk độc lập; reranker nhìn chúng cùng nhau, nên bắt được sắc thái mà cosine similarity bỏ sót.
Cái giá là độ trễ — rerank tốn thời gian. Nên tôi chỉ rerank top-k thô (50), không rerank toàn corpus. Đây là một đánh đổi tôi cân theo từng dự án, giống mọi quyết định kiến trúc khác.
Tầng 5 — Eval: nếu không đo được, bạn không sở hữu nó
Đây là tầng tách người vận hành RAG khỏi người demo RAG. Không có eval, mọi cải tiến chỉ là cảm tính, và bạn không bao giờ biết một thay đổi làm hệ thống tốt lên hay tệ đi.
Tôi dựng một golden set: vài trăm cặp (câu hỏi → tài liệu nguồn đúng → đáp án mong đợi), gồm cả những câu mà đáp án đúng là "không có thông tin". Rồi đo bằng các chỉ số tách bạch trách nhiệm:
- Recall@k — tài liệu đúng có nằm trong top-k truy hồi không? (đo riêng tầng retrieval)
- Faithfulness / Groundedness — câu trả lời có bám sát nguồn đã truy hồi, không bịa thêm? (đo riêng tầng sinh)
- Tỷ lệ "không biết" đúng lúc — khi không có nguồn, hệ thống có chịu nói "không có thông tin" thay vì phỏng đoán không?
Bảng eval: cộng dồn từng kỹ thuật
Đây là hình dạng kết quả tôi thường thấy khi bật từng tầng trên cùng một golden set. Tôi không đưa con số: mỗi bộ tài liệu cho ra mức khác nhau, và một bảng phần trăm không gắn với dự án cụ thể rất dễ bị đọc như số đo thật.
| Cấu hình | Chỉ số thường nhích rõ nhất | Loại lỗi được đóng |
|---|---|---|
| Naive (chunk cố định + chỉ vector) | — (mốc so sánh) | — |
| + Structure-aware chunking | Recall@5, Faithfulness | Điều khoản, bảng bị cắt đôi nên đoạn truy hồi được thiếu ý |
| + Hybrid search (BM25) | Recall@5 | Mã số, tên riêng, số điều khoản mà vector tìm trượt |
| + Reranker | Faithfulness | Đoạn gần nghĩa nhưng sai chen lên đầu kết quả |
Điều đáng chú ý là đường đi: mỗi tầng đóng một loại lỗi riêng, và bạn chỉ biết tầng nào đáng tiền khi có bảng này. Một đội báo giá RAG mà không nói được sẽ đo bằng gì, thường là đội chưa từng phải chịu trách nhiệm khi hệ thống trả lời sai trong production.
Đọc một bảng eval và phản biện đầu ra của AI thay vì tin tưởng mù quáng — đó chính là kỹ năng Discernment, một trong 4 trụ tôi tóm tắt ở ghi chú khoá AI Fluency.
RAG này KHÔNG phải cái gì — để khỏi mua nhầm
Tôi nói thẳng cho đúng kỳ vọng. Pipeline này tối ưu cho độ chính xác trên tập tài liệu doanh nghiệp (knowledge base, hợp đồng, quy trình nội bộ) ở quy mô SME đến tập đoàn tầm trung. Nó không phải:
- Một nền tảng xử lý hàng tỷ vector real-time — đó là bài toán hạ tầng khác, cần đội data engineering riêng.
- Một lời hứa "0% sai tuyệt đối" — không hệ thống nào hứa được; cái bạn mua là kiểm soát được và đo được sai số.
- Một lý do để bỏ qua chất lượng dữ liệu nguồn — tài liệu nguồn loạn thì kết quả loạn, và đó là việc cần làm trước khi bàn tới model.
Nếu bạn đang cân nhắc đưa RAG vào một quy trình mà câu trả lời sai có cái giá thật — và muốn làm với người đo được hệ thống của mình chứ không chỉ demo nó — bạn có thể xem thêm năng lực AI Automation, đọc các câu chuyện dự án thực tế, hoặc gửi bài toán hệ thống để cùng trao đổi.
Khi nào KHÔNG cần kiến trúc này?
Tôi không tin vào việc áp một kiến trúc nặng cho mọi bài toán. Khung 3 lớp này không cần thiết nếu:
- Bạn làm một internal tool tra cứu nội bộ, sai một chút không sao, không có yếu tố pháp lý.
- Khối lượng câu hỏi nhỏ, chi phí review thủ công còn rẻ hơn chi phí xây pipeline.
- Domain của bạn cho phép câu trả lời "gần đúng" (ví dụ gợi ý nội dung, brainstorm).
Với những trường hợp đó, một RAG đơn giản hoặc thậm chí không cần RAG là lựa chọn đúng. Tôi đã nói về cái bẫy "đốt tiền vào AI sai chỗ" trong bài Automation thất bại: những bài học.
Kiến trúc 3 lớp dành cho khi một câu trả lời sai có cái giá thực sự — và đó chính là lúc nó đáng từng đồng.
Ảo giác (hallucination) là giới hạn cố hữu của LLM, không phải lỗi cấu hình — hiểu đúng bản chất này mới đặt được ngưỡng review hợp lý thay vì kỳ vọng "0% sai". Tôi tóm tắt cơ chế đó trong ghi chú khoá AI Capabilities & Limitations.
Nếu bạn đang cân nhắc đưa AI/RAG vào một quy trình mà sai số có cái giá thật — và cần một người từng chịu trách nhiệm kiến trúc loại hệ thống này từ đầu đến vận hành — bạn có thể xem thêm năng lực AI Automation, đọc các câu chuyện dự án thực tế, hoặc gửi bài toán hệ thống để cùng trao đổi.
Nguyễn Phúc Nguyên Châu
Delivery Manager / System Architect
14 năm kinh nghiệm kiến trúc và vận hành hệ thống cho thị trường Việt – Nhật
Câu hỏi thường gặp
Vì sao dùng model mạnh hơn không giải quyết được hallucination?
Vì hallucination là vấn đề kiến trúc, không phải vấn đề năng lực model. Một model mạnh vẫn bịa khi không có cơ chế ràng buộc câu trả lời vào nguồn dữ liệu đã kiểm chứng, nên cần lớp kiểm soát truy xuất và xác thực.
Khi nào KHÔNG cần kiến trúc chống ảo giác 3 lớp?
Khi sai số nhỏ không gây hậu quả nghiêm trọng, ví dụ chatbot gợi ý nội dung hoặc tra cứu thông tin chung. Kiến trúc 3 lớp thêm chi phí và độ trễ, chỉ xứng đáng khi một câu trả lời sai có thể gây rủi ro pháp lý hoặc tài chính.
RAG có loại bỏ hoàn toàn hallucination không?
Không có hệ thống nào đảm bảo 0% tuyệt đối. Nhưng với kiến trúc 3 lớp — input gating, retrieval grounding bắt buộc trích nguồn, và human-in-loop ở vùng rủi ro — bạn có thể đẩy rủi ro về mức chấp nhận được cho enterprise, và quan trọng hơn là kiểm soát được khi nó xảy ra (truy vết được lý do).
Nên fine-tune model hay dùng RAG cho dữ liệu doanh nghiệp?
Trong hầu hết case enterprise tôi gặp, RAG thắng: dữ liệu thay đổi liên tục (cập nhật điều khoản, tài liệu mới), fine-tune lại tốn kém và khó truy vết nguồn. RAG cho phép cập nhật tri thức bằng cách cập nhật index, và luôn trích dẫn được nguồn — yếu tố bắt buộc khi cần compliance.
Chi phí lớn nhất khi xây Custom RAG enterprise nằm ở đâu?
Không phải ở model hay hạ tầng — mà ở chuẩn hoá dữ liệu nguồn (Lớp 1) và thiết kế ngưỡng/luồng review (Lớp 2–3). Đây là phần "không sexy" nhưng quyết định hệ thống sống hay chết. Đội nào báo giá chỉ tính tiền model thường là đội chưa từng vận hành RAG thật trong môi trường khắt khe. Chính cái retrieval engine bên dưới — chunking, hybrid search, reranking và bảng eval có số — tôi mổ xẻ ở phần pipeline 5 tầng ngay trong bài.
Chỉ số quan trọng nhất để đánh giá một hệ thống RAG là gì?
Là retrieval recall (Recall@k) và faithfulness/groundedness, không phải "câu trả lời nghe hay". Recall@k đo xem tài liệu đúng có nằm trong top-k truy hồi không; faithfulness đo xem câu trả lời có bám sát nguồn đã truy hồi không. Nếu retrieval sai, mọi thứ phía sau đều sai.
Khi nào cần hybrid search thay vì chỉ dùng vector search?
Khi truy vấn chứa mã định danh chính xác — số hợp đồng, mã điều khoản, mã sản phẩm. Vector search giỏi ngữ nghĩa nhưng dở ở khớp chính xác (exact match); thêm BM25 (sparse) rồi hợp nhất kết quả giúp bắt được cả hai loại truy vấn.
Vector DB nào nên dùng?
Câu trả lời đúng là "tùy quy mô", không phải "cái nào hot nhất". Ở quy mô SME, một Postgres với pgvector thường là đủ và đơn giản để vận hành. Khi số lượng vector và yêu cầu latency tăng, một vector DB chuyên dụng (Qdrant, Milvus...) mới đáng cái chi phí vận hành thêm. Chọn vector DB trước khi biết quy mô là đặt cày trước trâu.